Code : MO-PLT-023 | Version : 1.1 | Date : 26 juin 2026 | Auteur : C. Legrand

¶ MO-PLT-023 — Gérer les règles d'alerte Prometheus
v1.0 — 13 juin 2026 : création initiale — documentation des 7 règles en place, cycle édition → validation promtool → rechargement à chaud.
¶ 1. Objet
Ce mode opératoire décrit la gestion des règles d'alerte de la supervision Prometheus : lire les règles en place, en ajouter ou en modifier, valider la syntaxe avant application, recharger la configuration sans coupure et suivre le cycle de vie d'une alerte. Les règles sont évaluées en continu côté serveur : elles détectent les situations anormales indépendamment de toute consultation des dashboards.
Le document précise également la limite actuelle assumée du dispositif : les alertes sont visibles dans les interfaces, mais aucune notification n'est expédiée (pas de relais SMTP joignable depuis le VLAN serveurs).
¶ 2. Champ d'application
| Public concerné | Administrateurs de l'infrastructure BTS SIO |
| Application | Prometheus v3.3.1 — CT 200 docker-srv (10.0.112.20) |
| Fichier de règles | /opt/docker/monitoring/alerts.yml, monté dans le conteneur en /etc/prometheus/alerts.yml |
| Outils | éditeur de texte, promtool (embarqué dans le conteneur), curl |
| Durée | 10 minutes pour l'ajout d'une règle |
¶ 3. Concepts
¶ 3.1 Anatomie d'une règle
- alert: InstanceDown
  expr: up == 0
  for: 5m
  labels:
    severity: critical
  annotations:
    summary: "Cible {{ $labels.instance }} injoignable"
    description: "La cible {{ $labels.instance }} (job {{ $labels.job }})
      ne répond plus depuis 5 minutes."
expr: la condition, évaluée toutes les 15 secondes sur chaque série concernée ;for: la durée pendant laquelle la condition doit rester vraie avant déclenchement — l'amortisseur anti-faux-positifs ;labels: métadonnées de classement (sévérité) ;annotations: textes destinés aux humains ; les gabarits{{ $labels.xxx }}sont remplacés par les labels de la série fautive — d'où l'intérêt des libellés lisibles (cf. MO-PLT-022).
¶ 3.2 Cycle de vie d'une alerte
| État | Signification |
|---|---|
inactive |
Condition fausse : situation nominale. |
pending |
Condition vraie depuis moins longtemps que le for : alerte en observation. |
firing |
Condition vraie depuis plus longtemps que le for : alerte déclenchée, visible partout. |
¶ 3.3 Les sept règles en place
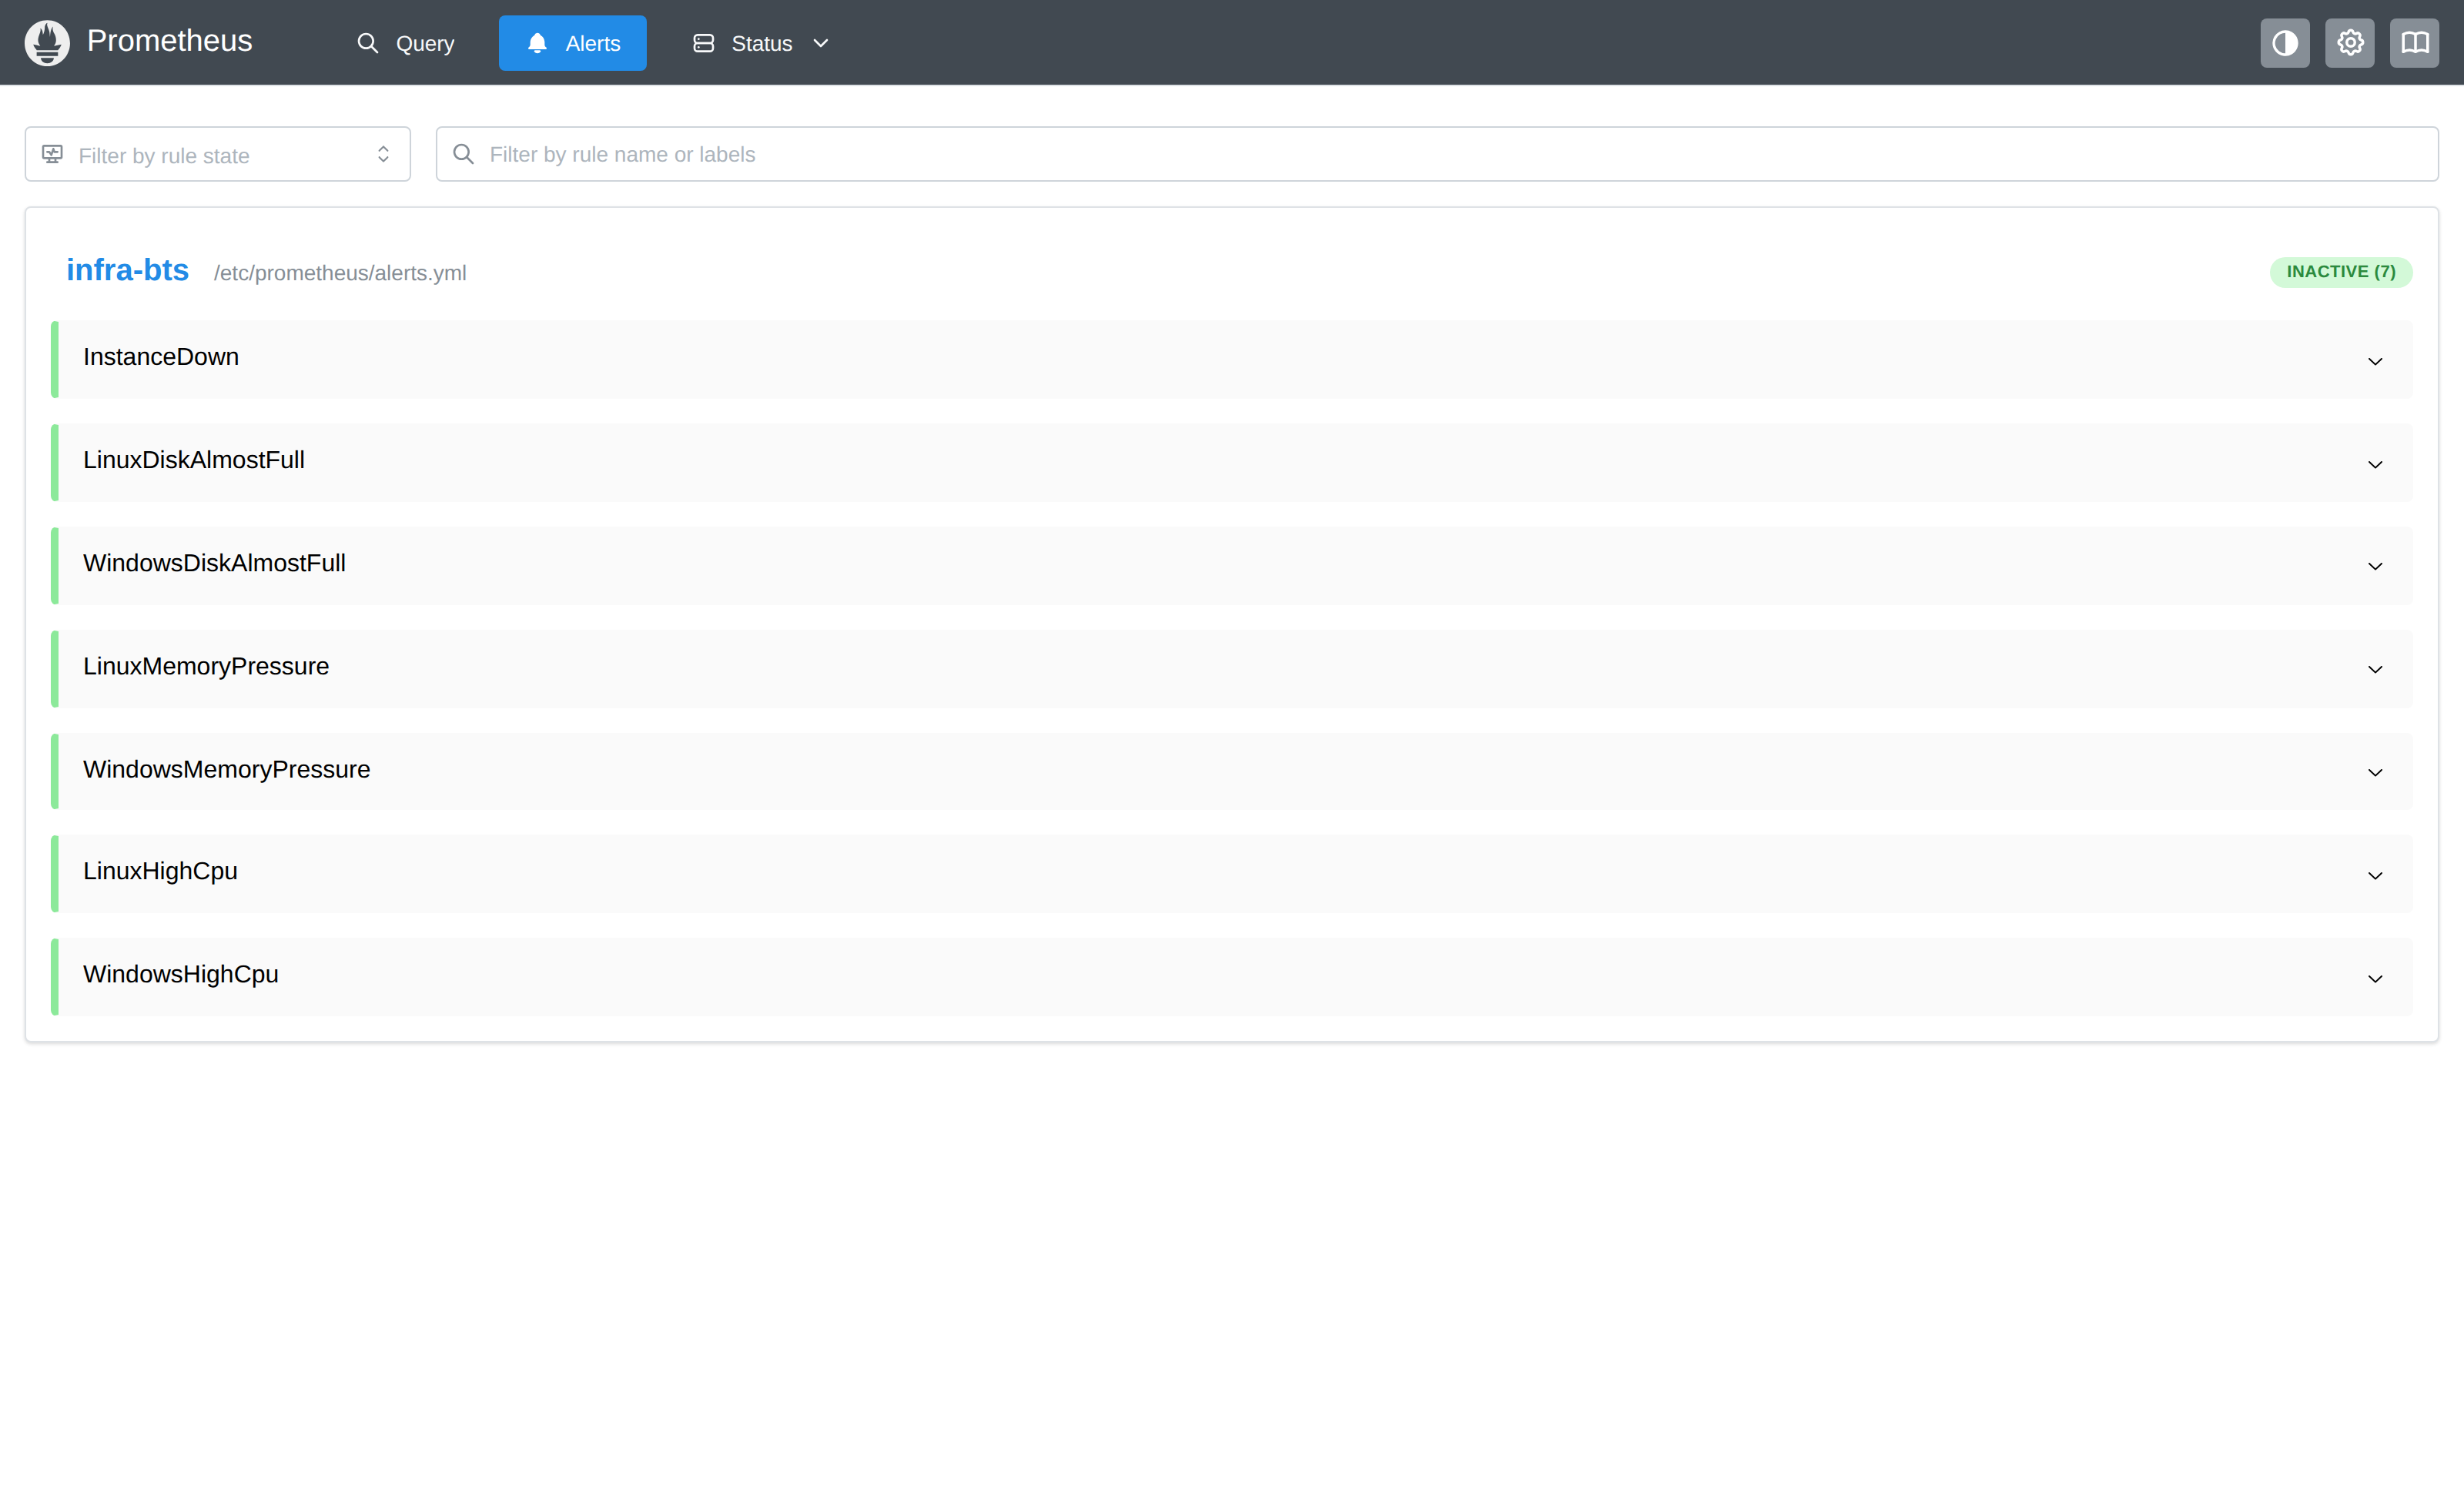
| Règle | Condition | Seuil | for | Sévérité |
|---|---|---|---|---|
| InstanceDown | cible injoignable (up == 0) |
— | 5 min | critical |
| LinuxDiskAlmostFull | espace libre d'un système de fichiers | < 15 % | 10 min | warning |
| WindowsDiskAlmostFull | espace libre d'un volume | < 15 % | 10 min | warning |
| LinuxMemoryPressure | mémoire utilisée | > 90 % | 10 min | warning |
| WindowsMemoryPressure | mémoire disponible | < 10 % | 10 min | warning |
| LinuxHighCpu | CPU moyen | > 85 % | 15 min | warning |
| WindowsHighCpu | CPU moyen | > 85 % | 15 min | warning |
Les règles sont volontairement génériques : elles portent sur des familles de métriques et non sur des serveurs nommés. Toute nouvelle cible ajoutée à la collecte est couverte immédiatement, sans modification du fichier.
Détection sans notification. En l'état, une alerte
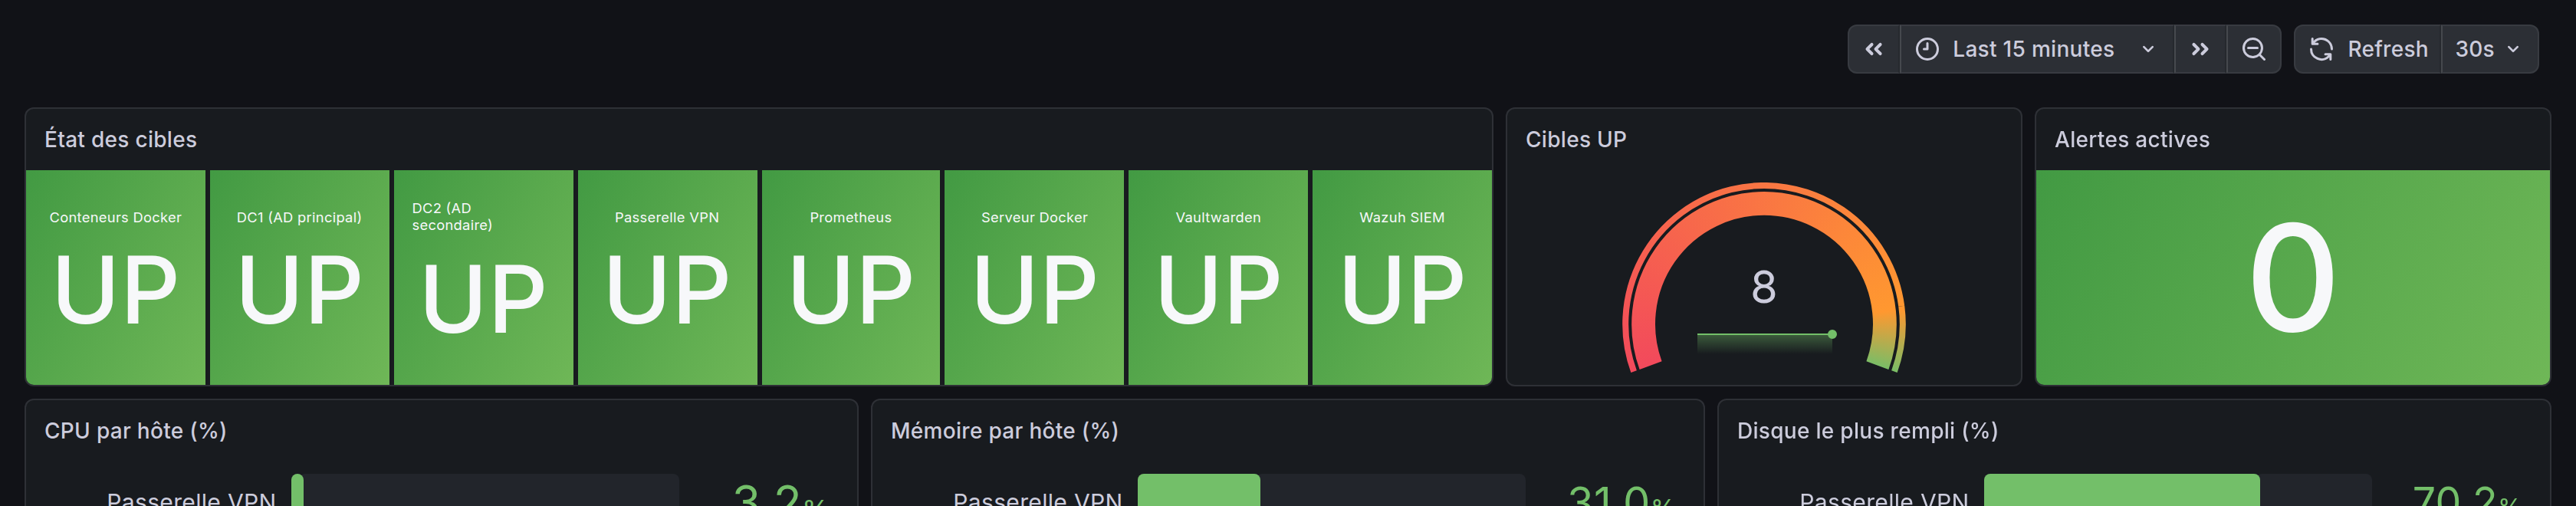
firingne déclenche aucun envoi (ni courriel, ni messagerie) : le VLAN serveurs n'a pas d'accès Internet et aucun relais SMTP interne n'est joignable. La détection est fiable, mais sa consultation reste à l'initiative de l'équipe (vue d'ensemble Grafana en page d'accueil, page Alerts de Prometheus). Le chaînon manquant — un Alertmanager relayé par un hôte disposant d'une sortie — est identifié comme évolution possible et devra faire l'objet d'une décision d'équipe.
¶ 4. Prérequis
- Accès SSH
rootau CT 200 (10.0.112.20), via le VPN WireGuard - Notions de base de PromQL
- Connaître le nom des métriques visées (auto-complétion de la barre de requête Prometheus)
¶ 5. Procédure
¶ Étape 1 — Consulter l'état des règles
Dans l'interface Prometheus (cf. MO-PLT-015), ouvrir le menu Alerts : chaque règle apparaît avec son état courant et le détail de sa définition.
¶ Étape 2 — Ajouter ou modifier une règle
cd /opt/docker/monitoring
cp alerts.yml alerts.yml.bak
nano alerts.yml
Exemple d'ajout — un second seuil disque, critique, qui se déclenche plus vite quand la situation devient urgente :
- alert: LinuxDiskFullCritical
  expr: (node_filesystem_avail_bytes{fstype!~"tmpfs|overlay|squashfs"}
        / node_filesystem_size_bytes{fstype!~"tmpfs|overlay|squashfs"}) < 0.05
  for: 5m
  labels:
    severity: critical
  annotations:
    summary: "Disque < 5 % libre sur {{ $labels.instance }} ({{ $labels.mountpoint }})"
Tester l'expression avant d'en faire une règle : coller le
exprseul dans la barre de requête de Prometheus. S'il ne retourne aucune série alors que la situation visée existe, la règle ne se déclenchera jamais.
¶ Étape 3 — Valider la syntaxe avec promtool
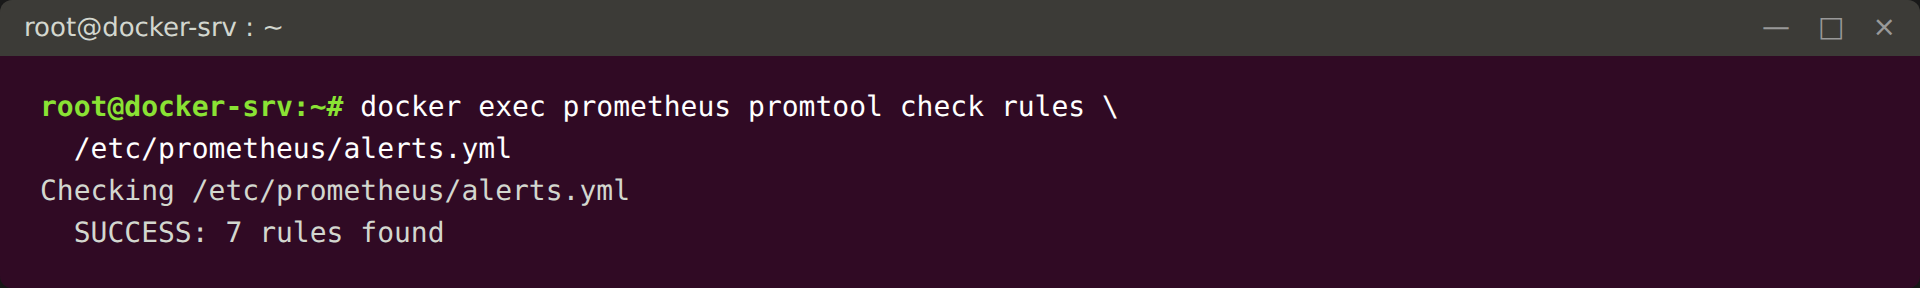
docker exec prometheus promtool check rules /etc/prometheus/alerts.yml
¶ Étape 4 — Recharger la configuration à chaud
curl -X POST http://127.0.0.1:9090/-/reload
Le rechargement est immédiat et sans interruption de la collecte. La nouvelle règle apparaît dans Alerts à l'état inactive.
¶ Étape 5 — Suivre une alerte déclenchée
Trois points d'observation, du plus synthétique au plus détaillé :
- la tuile « Alertes actives » de la vue d'ensemble Grafana (page d'accueil) passe de 0 (vert) au nombre d'alertes
firing(rouge) ; - la page Alerts de Prometheus détaille les séries fautives et l'horodatage ;
- en PromQL, la métrique
ALERTS{alertstate="firing"}permet de filtrer, compter ou croiser les alertes.
¶ 6. Vérification
-
promtool check rulesretourneSUCCESSavec le nombre de règles attendu - Le rechargement répond sans erreur
- La règle apparaît dans Alerts à l'état
inactive(situation nominale) - L'expression testée seule retourne des séries cohérentes
- Le fichier
alerts.yml.bakexiste en cas de retour arrière
¶ 7. Rollback
cd /opt/docker/monitoring
cp alerts.yml.bak alerts.yml
docker exec prometheus promtool check rules /etc/prometheus/alerts.yml
curl -X POST http://127.0.0.1:9090/-/reload
¶ 8. Dépannage
| Problème | Solution |
|---|---|
promtool refuse le fichier |
L'erreur indique la ligne fautive : indentation YAML ou expression PromQL invalide. Prometheus continue avec l'ancienne version tant que le rechargement n'a pas eu lieu. |
La règle ne passe jamais à pending |
L'expression ne matche aucune série. La tester seule ; vérifier le nom exact de la métrique et les filtres. |
| L'alerte bascule sans arrêt | La métrique oscille autour du seuil. Allonger le for ou écarter le seuil de la valeur de croisière. |
| Annotations avec des champs vides | Le label référencé n'existe pas sur la série (ex. mountpoint sur une métrique Windows). |
| Personne n'a vu une alerte déclenchée | Limite documentée (pas de notification sortante). Prendre le réflexe de la vue d'ensemble en début de journée ; inscrire l'évolution Alertmanager à l'ordre du jour. |
¶ 9. Voir aussi
- MO-PLT-022 — Ajouter un serveur à la supervision Les règles génériques couvrent les nouvelles cibles
- MO-PLT-015 — Se connecter à Prometheus Pages Alerts et Targets
- MO-PLT-024 — Dashboards Grafana La tuile Alertes actives de la vue d'ensemble
- MO-SEC-001 — Exploitation de Wazuh Alertes de sécurité, complémentaires des alertes de métriques
¶ Références
- Prometheus — Alerting rules (syntaxe, états, gabarits d'annotations)
- Prometheus — promtool (validation de configuration et de règles)
- Google — Site Reliability Engineering, chap. Practical Alerting
- ANSSI — Recommandations de sécurité pour la journalisation et la supervision